AIアプリケーション
使用するAIモデルを選択してください
動画生成
Lightricks LTX-2.5 Fast
78
Vidu Q3 Turbo 画像から動画
12
Google Veo3.1 Lite テキストから動画
84
Google Veo3.1 Lite 画像から動画
84
Wan 2.6 画像から動画 Flash
24
Seedance V1.5 Pro 画像から動画 高速版
100
Steady Dancer
80
Minimax Hailuo 2.3 Fast 画像からショート動画
108
Seedance V1 Pro Fast テキスト→動画
20
Seedance 2.0 Fast テキストから動画
500
Seedance 2.0 Fast 画像から動画
500
Wan 2.1 Mocha
60
Lightricks LTX-2 Fast テキストから動画
120
Lightricks LTX-2 Fast 画像から動画
120
Wan 2.5 画像から動画(高速)
150
Wan 2.2 Animate
50
動画フェイススワップ
30
Wan 2.2 画像から動画高速版
20
画像生成
OpenAI GPT Image 2
5
OpenAI GPT Image 2 Edit
13
Nano Banana 2 テキスト to 画像(Gemini 3.1 Flash)
33
Nano Banana 2 画像編集(Gemini 3.1 Flash)
33
Seedream V5.0 Lite(Bytedance)
17
Seedream V5.0 Lite Edit(Bytedance)
17
Qwen 多角度画像編集
12
Flux 2 Klein 9B Edit
8
Qwen 画像編集 2511
15
OpenAI GPT Image 1.5
5
Ernie テキストから画像生成
13
Ernie テキストから画像生成 Turbo
13
Seedream V4.5(Bytedance)
20
Z-Image-Turbo
1
Z-Image-Base
4
NVIDIA Chrono Edit
10
Hunyuan Image 3
6
Flux 1 Srpo
5
Seedream V4(Bytedance)
6
Seedream V4 画像編集(Bytedance)
6
Qwen 画像編集
10
Nano Banana(Gemini 2.5 画像編集)
5
画像アップスケーラー
5
Flux Dev
3
Qwen Image
3
FLUX.1 Krea [dev]
4
ヘアスタイル変換
5
ブロッコリーヘアスタイル試着
5
顔の多様なスタイル変換
4
FLUX.1 スピード版
1
FLUX.1 Kontext 開発版
4
Seedance 2.0 Fast 画像から動画
参照画像からネイティブ音声同期、被写体の忠実な再現、表現豊かなモーションを備えた映画品質の動画を生成 — 標準版より33%低コストで高速生成。
コスト:500 クレジット
入力
出力
生成結果はここに表示されます
サンプル結果
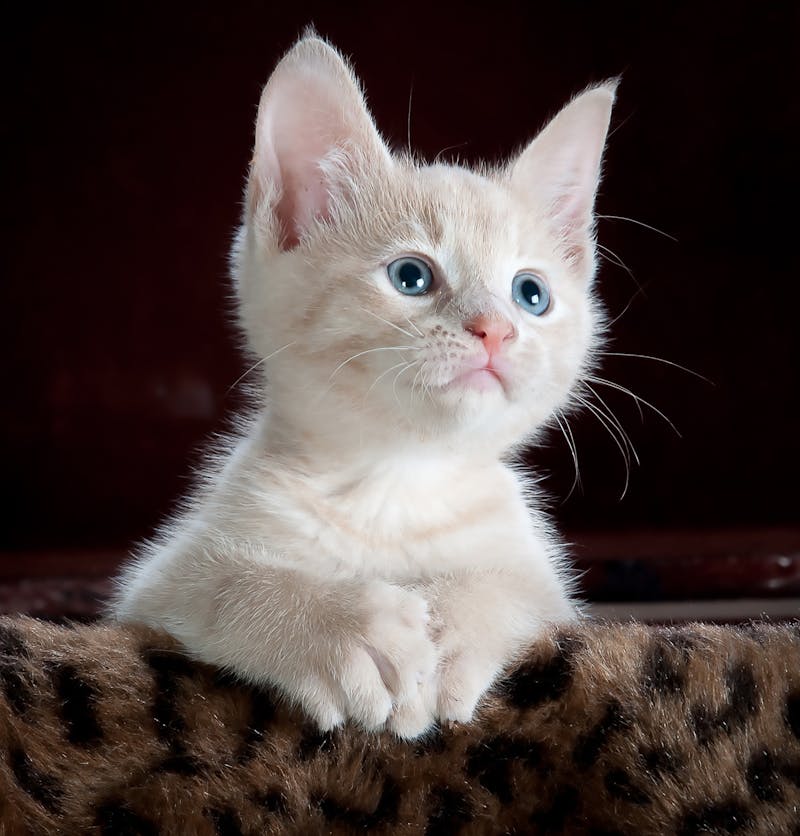
動画生成:
Reference image
動画生成:
The kitten slowly opens its eyes and stretches, yawning lazily, soft warm morning light
よくある質問
- 対応する画像フォーマットとサイズは?
- JPEG、PNG、WebPに対応。短辺720px以上で被写体が明確・照明の良い画像が最適です。様々な解像度に対応しますが、高圧縮JPEG(品質50未満)や256px未満の画像ではアーティファクトが出る可能性があります。出力動画のアスペクト比は入力画像に自動的に合わせられます。
- モデルはどのようにモーションを決める?
- 参照画像とテキストプロンプトを組み合わせてモーションを決定します。画像がビジュアルアイデンティティ(誰/何が、どこに)を固定し、プロンプトがアクション(何が起こるか)を駆動します。例えばポートレートをアップロードし「彼女が振り向いて肩越しに見る、風が髪を揺らす」と入力すると、その特定の人物がその特定の動きをします。
- 被写体の外見が変わるのを防ぐには?
- Seedance 2.0 Fastは被写体保持に特化設計されています — 顔の特徴、服装、シーン構図を入力と一致させます。忠実度を最大化するには:(1) 高解像度・良好な照明の参照画像を使用;(2) プロンプトは外見の変化でなくモーションに焦点;(3) 画像内容と矛盾する記述を避ける。
- 実際の生成時間はどれくらい?
- 目安:5秒クリップで約60〜90秒、10秒クリップで約120〜180秒、15秒クリップで約180〜300秒。サーバー負荷により変動。Fast版は標準版Seedance 2.0の約2倍の速度で処理されます。
- 画像から動画 vs テキストから動画、いつどちらを使う?
- 特定の画像をアニメーション化したい場合はImage-to-Video — 商品写真、キャラクターポートレート、ストーリーボードフレーム、他のAIで生成した画像など。アイデアだけで画像がない場合はText-to-Video。強力なコンボ:画像生成モデルで静止画を作り、Image-to-Videoで命を吹き込む。最大の創造的コントロールが得られます。
- AI生成画像を入力に使える?
- もちろんです。最も人気のあるワークフローの一つ — Flux、Stable Diffusionなどで静止画を生成し、Seedance 2.0 Fast I2Vでアニメーション化。ビジュアルスタイルとモーションの両方を精密にコントロールでき、AI生成画像の美学を忠実に保持します。
こちらもおすすめ
すべて見る84
Google Veo3.1 Lite 画像から動画
Google Veo 3.1 Lite で静止画を映画品質の 720p/1080p 動画に変換。横向き・縦向きのアスペクト比、ネガティブプロンプト制御、最大 8 秒のカスタマイズ可能な長さに対応。
今すぐ試す
84
Google Veo3.1 Lite テキストから動画
Google Veo 3.1 Lite でテキストプロンプトから映画品質の 720p/1080p 動画を生成。横向き・縦向きのアスペクト比、ネガティブプロンプト制御、最大 8 秒のカスタマイズ可能な長さに対応。
今すぐ試す
近日公開
Seedance 2.0 API
ByteDance の次世代 AI 動画モデル。2K シネマ品質出力、ネイティブ音声・映像同期、最大 12 素材のマルチモーダル入力、マルチショット・ストーリーテリング、8 言語以上のリップシンクをワンプロンプトで実現。
近日公開