AIアプリケーション
使用するAIモデルを選択してください
動画生成
Lightricks LTX-2.5 Fast
78
Vidu Q3 Turbo 画像から動画
12
Google Veo3.1 Lite テキストから動画
84
Google Veo3.1 Lite 画像から動画
84
Wan 2.6 画像から動画 Flash
24
Seedance V1.5 Pro 画像から動画 高速版
100
Steady Dancer
80
Minimax Hailuo 2.3 Fast 画像からショート動画
108
Seedance V1 Pro Fast テキスト→動画
20
Seedance 2.0 Fast テキストから動画
500
Seedance 2.0 Fast 画像から動画
500
Wan 2.1 Mocha
60
Lightricks LTX-2 Fast テキストから動画
120
Lightricks LTX-2 Fast 画像から動画
120
Wan 2.5 画像から動画(高速)
150
Wan 2.2 Animate
50
動画フェイススワップ
30
Wan 2.2 画像から動画高速版
20
画像生成
OpenAI GPT Image 2
5
OpenAI GPT Image 2 Edit
13
Nano Banana 2 テキスト to 画像(Gemini 3.1 Flash)
33
Nano Banana 2 画像編集(Gemini 3.1 Flash)
33
Seedream V5.0 Lite(Bytedance)
17
Seedream V5.0 Lite Edit(Bytedance)
17
Qwen 多角度画像編集
12
Flux 2 Klein 9B Edit
8
Qwen 画像編集 2511
15
OpenAI GPT Image 1.5
5
Ernie テキストから画像生成
13
Ernie テキストから画像生成 Turbo
13
Seedream V4.5(Bytedance)
20
Z-Image-Turbo
1
Z-Image-Base
4
NVIDIA Chrono Edit
10
Hunyuan Image 3
6
Flux 1 Srpo
5
Seedream V4(Bytedance)
6
Seedream V4 画像編集(Bytedance)
6
Qwen 画像編集
10
Nano Banana(Gemini 2.5 画像編集)
5
画像アップスケーラー
5
Flux Dev
3
Qwen Image
3
FLUX.1 Krea [dev]
4
ヘアスタイル変換
5
ブロッコリーヘアスタイル試着
5
顔の多様なスタイル変換
4
FLUX.1 スピード版
1
FLUX.1 Kontext 開発版
4
Qwen 画像編集 2511
複数画像参照をサポートする高度なAI画像編集。自然言語プロンプトで画像を編集し、最大3枚の参照画像でコンテキスト認識編集が可能です。
コスト:15 クレジット
入力
出力
生成結果はここに表示されます
サンプル結果
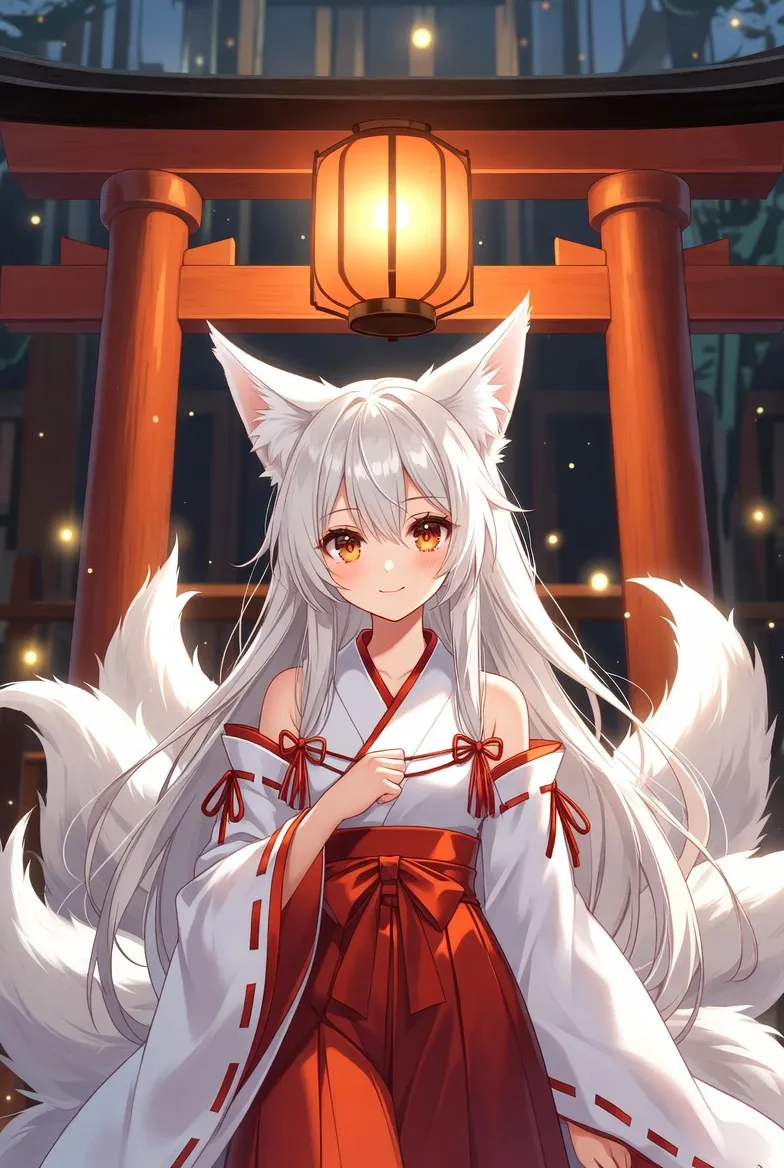
画像編集:
Reference image 1
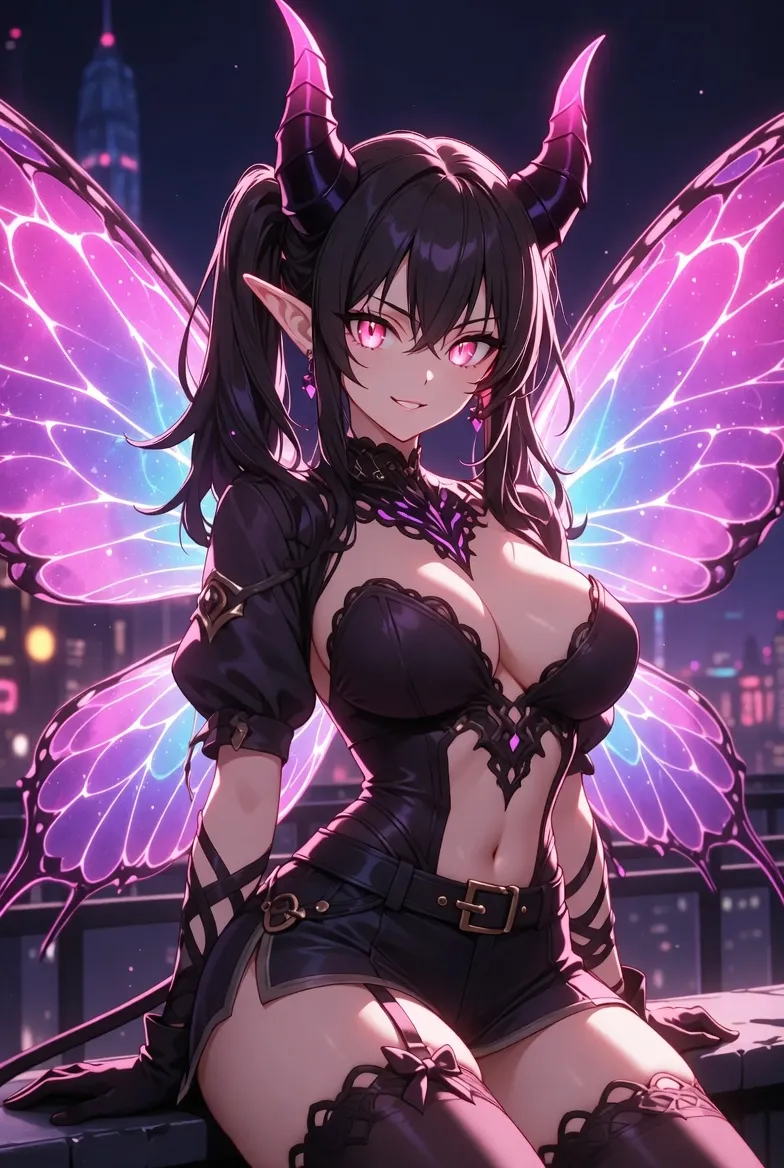
画像編集:
Reference image 2
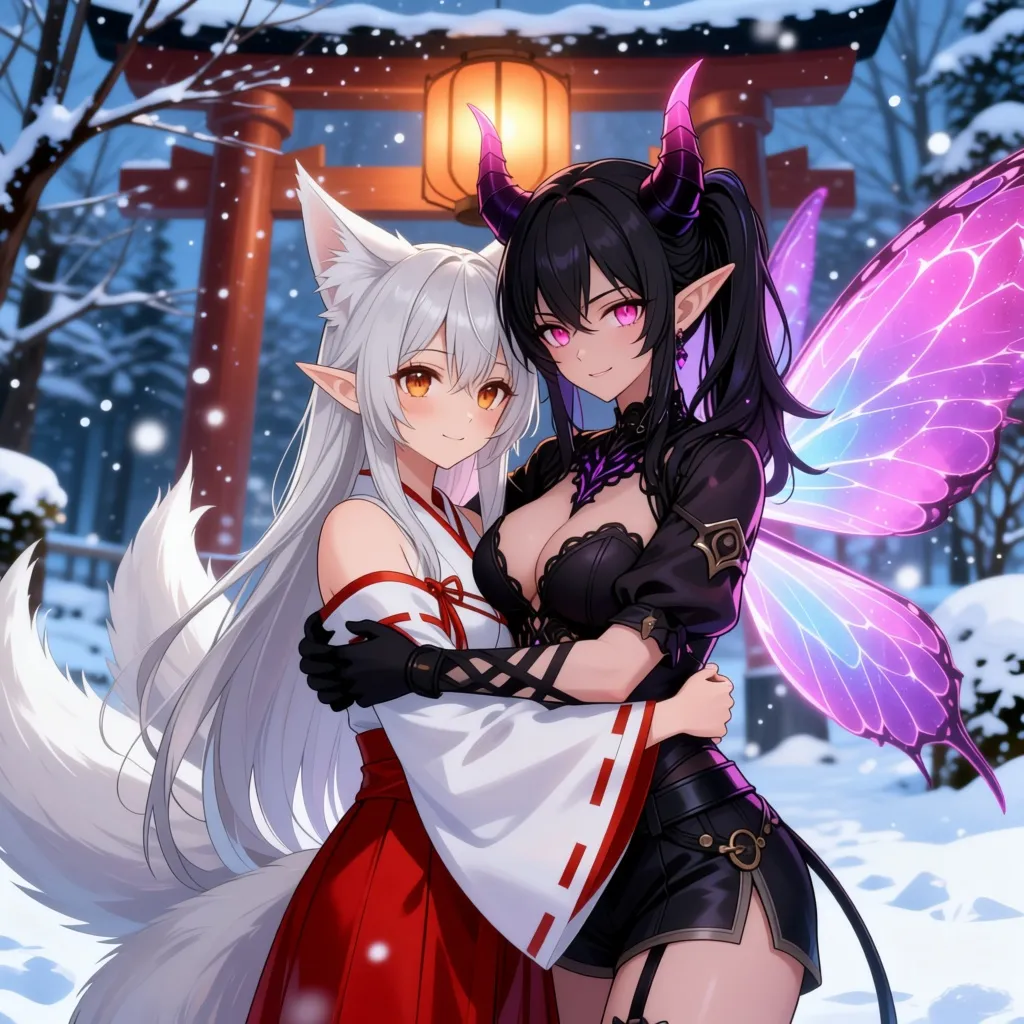
画像編集:
two people is hugging in the winter background"
よくある質問
- Qwen 画像編集 2511とは?
- Qwen 画像編集 2511は、Qwenの画像編集モデルの高度なバージョンです。複数画像参照入力(最大3枚)をサポートし、複数の視覚的参照に基づいたより文脈を考慮した正確な編集が可能です。
- 通常のQwen画像編集との違いは?
- 2511バージョンは、1枚だけでなく複数の参照画像(1〜3枚)をサポートしています。これにより、ある画像からスタイル転送を行いながら別の画像のコンテンツを保持するなど、より複雑な編集シナリオが可能になります。
- どのような種類の編集をサポートしていますか?
- セマンティック編集(視点変更、スタイル転送)、外観編集(オブジェクトの追加/削除)、テキスト編集(画像内のテキストの追加、変更、削除)、および複数参照編集(複数の画像から要素を組み合わせる)をサポートしています。
- 複数の参照画像をどのように使用すればよいですか?
- 編集のコンテキストを提供する1〜3枚の画像をアップロードしてください。例:1枚をメインの被写体として、もう1枚をスタイル参照として、3枚目を特定の要素用として使用します。プロンプトで各画像が結果にどのように影響するかを説明してください。
- どの入力フォーマットがサポートされていますか?
- JPEG、PNG、WebP画像がサポートされています。最良の結果を得るために、各画像は鮮明で明るい必要があります。
- 効果的なプロンプトの書き方は?
- 変更する部分と保持する部分を具体的に指定してください。どのアップロード画像にどの要素が含まれているかを参照してください。例:「画像1のポートレートに画像2のアーティスティックスタイルを適用し、画像3の背景を維持する」
- 出力サイズのオプションは?
- 出力サイズは512×512から1536×1536ピクセルまでの範囲です。品質のニーズに応じて選択してください。大きいサイズはより詳細ですが、生成に時間がかかる場合があります。
- 画像内のテキスト編集をサポートしていますか?
- はい。オリジナルのQwen画像編集と同様に、英語と中国語の文字を含む正確なテキスト編集に優れています。周囲のデザインを保持しながら、テキストを追加、変更、または削除できます。
- 生成にはどのくらい時間がかかりますか?
- ほとんどの編集は30〜60秒以内に完了します。画像の複雑さ、参照画像の数、サーバーの負荷によって異なります。
- 結果を商用利用できますか?
- 商用利用についてはモデルのライセンスとプラットフォームポリシーをご確認ください。一般的に、自分のアップロードから作成したコンテンツの権利は保持されますが、モデルとプラットフォームの利用規約に従う必要があります。
こちらもおすすめ
すべて見るRecommended for Editing
33
Try Nano Banana 2 画像編集(Gemini 3.1 Flash)
Get stronger subject consistency and multi-reference editing with Nano Banana 2 Edit.
Try Nano Banana 2 Edit
4
FLUX.1 Krea [dev]
過度に飽和したAIの外観を避け、独特の美学を持つフォトリアリスティックな画像生成。
今すぐ試す
1
FLUX.1 スピード版
速度に最適化されたモデルで、テキストプロンプトから素早く画像を生成します。元のモデルと比較して約3倍の高速化を実現し、品質の低下は最小限です。
今すぐ試す
5
OpenAI GPT Image 1.5
OpenAIの最新モデルGPT Image 1.5を使用して、高品質でフォトリアルな画像を生成します。複雑な指示への追従性や、細部のレンダリングに優れています。
今すぐ試す