AI应用
选择一个AI模型开始使用
视频生成
Lightricks LTX-2.5 Fast
78
Vidu Q3 Turbo 图生视频
12
Google Veo3.1 Lite 文字生成视频
84
Google Veo3.1 Lite 图片生成视频
84
Wan 2.6 图生视频 Flash
24
Seedance V1.5 Pro 图生视频快速版
100
Steady Dancer 动感角色视频
80
Minimax Hailuo 2.3 Fast 图片转短视频
108
Seedance V1 Pro Fast 文本生成视频
20
Seedance 2.0 Fast 文本生成视频
500
Seedance 2.0 Fast 图片生成视频
500
Wan 2.1 Mocha
60
Lightricks LTX-2 Fast 文本转视频
120
Lightricks LTX-2 Fast 图片转视频
120
Wan 2.5 图片转视频(快速版)
150
Wan 2.2 动作驱动动画
50
视频换脸
30
Wan 2.2 图片转视频快速版
20
图像生成
OpenAI GPT Image 2
5
OpenAI GPT Image 2 Edit
13
Nano Banana 2 文生图(Gemini 3.1 Flash)
33
Nano Banana 2 图像编辑(Gemini 3.1 Flash)
33
Seedream V5.0 Lite(Bytedance)
17
Seedream V5.0 Lite Edit(Bytedance)
17
Qwen 多角度图像编辑
12
Flux 2 Klein 9B 图像编辑
8
Qwen 图像编辑 2511
15
OpenAI GPT Image 1.5
5
Ernie 文生图
13
Ernie 文生图 Turbo
13
Seedream V4.5(Bytedance)
20
Z-Image-Turbo
1
Z-Image-Base
4
NVIDIA Chrono Edit
10
Hunyuan Image 3
6
Flux 1 Srpo
5
Seedream V4(Bytedance)
6
Seedream V4 图像编辑(Bytedance)
6
Qwen 图像编辑
10
Nano Banana(Gemini 2.5 图像编辑)
5
图像放大(超分辨率)
5
Flux 开发版
3
Qwen 图像生成
3
FLUX.1 Krea [dev]
4
发型变换
5
西兰花发型试戴
5
人脸多风格转换
4
FLUX.1 快速版
1
FLUX.1 Kontext 开发版
4
Seedance 2.0 Fast 图片生成视频
从参考图片生成电影级视频,具备原生音视频同步、主题保真和表现力丰富的运动效果 — 生成速度更快,成本降低33%。
费用:500 积分
输入
输出
生成内容将显示在此处
示例结果
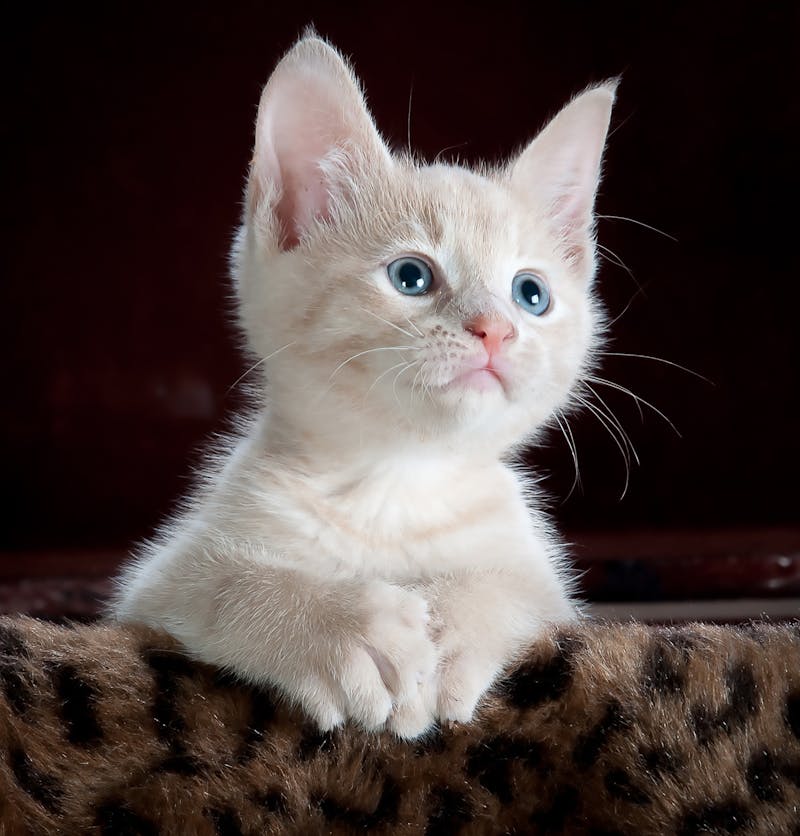
视频生成:
Reference image
视频生成:
The kitten slowly opens its eyes and stretches, yawning lazily, soft warm morning light
常见问题
- 支持哪些图片格式和尺寸?
- 支持 JPEG、PNG 和 WebP。建议短边至少 720px,主体清晰、光线充足。模型可处理不同分辨率,但高度压缩的 JPEG(质量 < 50)或低于 256px 的图片可能产生伪影。输出视频的画面比例自动匹配输入图片 — 上传横图得到16:9,上传竖图得到9:16。
- 模型如何决定添加什么运动?
- 模型结合参考图片和文本提示来决定运动方式。图片锚定视觉身份(谁/什么 + 在哪里),提示词驱动动作(发生什么)。例如上传一张人像照并输入'她转身回头看,风吹动头发',模型就会让这个特定的人做出特定的动作。不写提示词时,模型会根据场景上下文添加微妙的环境动态。
- 如何防止模型改变主体的外观?
- Seedance 2.0 Fast 专为主体保真设计 — 保持面部特征、服装和场景构图与输入一致。最大化保真度的方法:(1) 使用高分辨率、光线充足的参考图;(2) 提示词聚焦运动而非外观变化;(3) 避免与图片内容矛盾的描述(如参考图是深色头发,就不要写'金发')。
- 实际生成时间大约多久?
- 典型时间:5秒片段约60–90秒,10秒片段约120–180秒,15秒片段约180–300秒。实际时间随服务器负载波动。Fast 版本处理速度大约是标准版的2倍。
- 图片生成视频 vs 文本生成视频,什么时候用哪个?
- 有具体画面要动画化时用 Image-to-Video — 产品照片、角色肖像、分镜画面、或其他 AI 生成的图片。只有创意没有画面时用 Text-to-Video。强力组合:先用图像生成模型创建静态画面,再用 Image-to-Video 赋予它生命,获得最大创作控制力。
- 可以用 AI 生成的图片作为输入吗?
- 完全可以。这是最受欢迎的工作流之一 — 用 Flux、Stable Diffusion 等模型生成静态图片,然后用 Seedance 2.0 Fast I2V 把它动画化。这让你同时精确控制视觉风格和运动效果,模型会忠实保留 AI 生成图片的美学风格。
猜你喜欢
查看全部84
Google Veo3.1 Lite 图片生成视频
使用 Google Veo 3.1 Lite 将静态图片转化为电影级 720p/1080p 视频。支持横屏和竖屏比例、负向提示词控制,以及最长 8 秒的自定义时长。
立即尝试
84
Google Veo3.1 Lite 文字生成视频
使用 Google Veo 3.1 Lite 从文字提示生成电影级 720p/1080p 视频。支持横屏和竖屏比例、负向提示词控制,以及最长 8 秒的自定义时长。
立即尝试
即将上线
Seedance 2.0 API
字节跳动新一代 AI 视频模型,支持 2K 影院级画质、原生音视频同步、最多 12 个参考素材的多模态输入、多镜头叙事、8+ 语言唇形同步 —— 一个提示词搞定一切。
即将上线