Comfyui ビジュアルクエリテンプレートノード:精密な制御のため
Posted on August 4, 2025 - Comfyui

このComfyUIノードは、スマートなAIモデルを使って画像を言葉に変換します。まるで、写真に見えるものを説明できるロボットを持っているようなものです。
このノードは何のためのものですか?
コンピューターに画像の中身を教えてもらえたらいいのに、と思ったことはありませんか? それがまさにこのComfyUIノードの役割です。
このノードは「視覚的質問応答(VQA)」と呼ばれる技術を使って、画像を分析し、それに関する質問に答えます。
最もクールなのは、一つ一つ質問をする必要がないという点です。テンプレートを設定するだけで、AIが自動的に空欄を埋めてくれます。
例えば、こんな風に質問を設定できます: 「{目の色}の目、{髪型}の{髪の色}の髪、{民族} {性別}、{年齢}歳」
AIが画像を分析すると、こんな回答を返してくれるかもしれません: 「茶色の目、黒い巻き毛、アジア系の女性、25歳」
まるで、写真の説明が得意な超賢い友人がいるようなものです。
どのように動作するのですか?
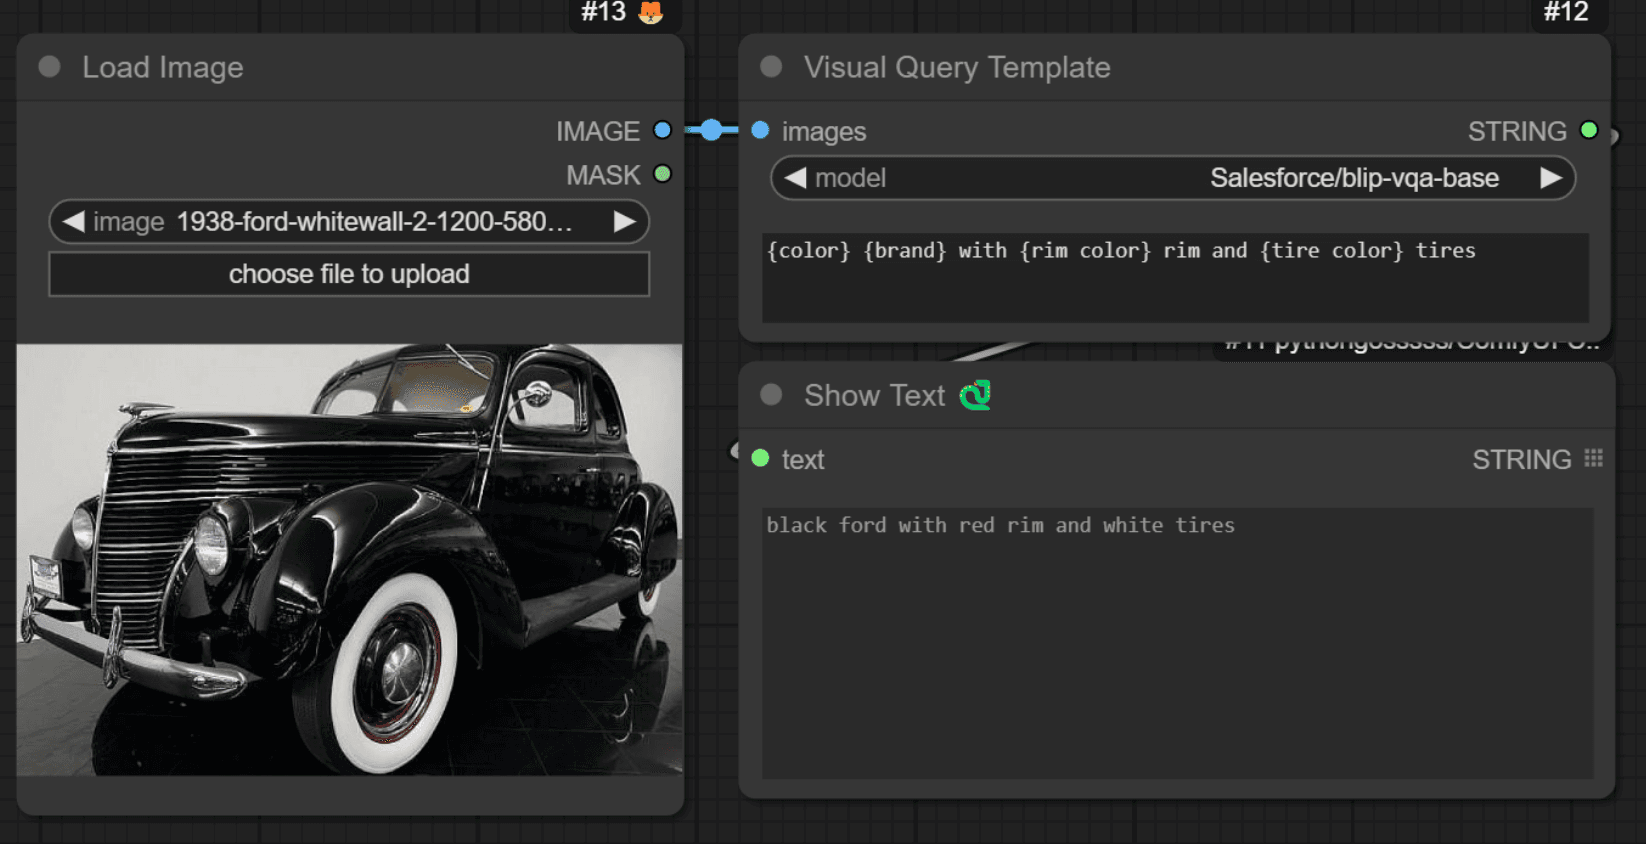
簡単に分解して説明すると:
- 画像をいくつか与えます
- AIモデルを選択します(いくつかの選択肢が用意されています)
- 波括弧{}内に質問を含むテンプレートを作成します
- ノードがその魔力を発揮します
- 各画像の説明が出力されます
これだけの簡単な手順です。テクノロジーの専門家である必要はありません。
なぜ使う必要があるのですか?
理由はたくさんあります:
- 視覚障害者のために写真を説明する
- 大量の画像をすばやく整理する
- 画像データベースを検索可能にする
- ソーシャルメディアの投稿のキャプションを作成する
- 写真のファッショントレンドを分析する
- オンラインショッピングを支援する(自動的に服を説明してくれると想像してみてください)
その可能性はほぼ無限大です。
技術的な詳細(心配しないで、簡単に説明します)
このノードはいくつかの賢い技術に基づいて構築されています:
- Hugging FaceのAIモデルを使用しています(まるでAIのスーパーマーケットのようなものです)
- さまざまな種類のVQAモデル(BLIP、ViLT、GITなど)に対応しています
- コンピューターの画像データをAIが理解できる通常の画像に変換します
- 処理にかかる時間を計測します(急いでいるときに役立ちます)
ですが、最も良い点は:これらを理解する必要はないということです。ただ動作するだけです。
始め方
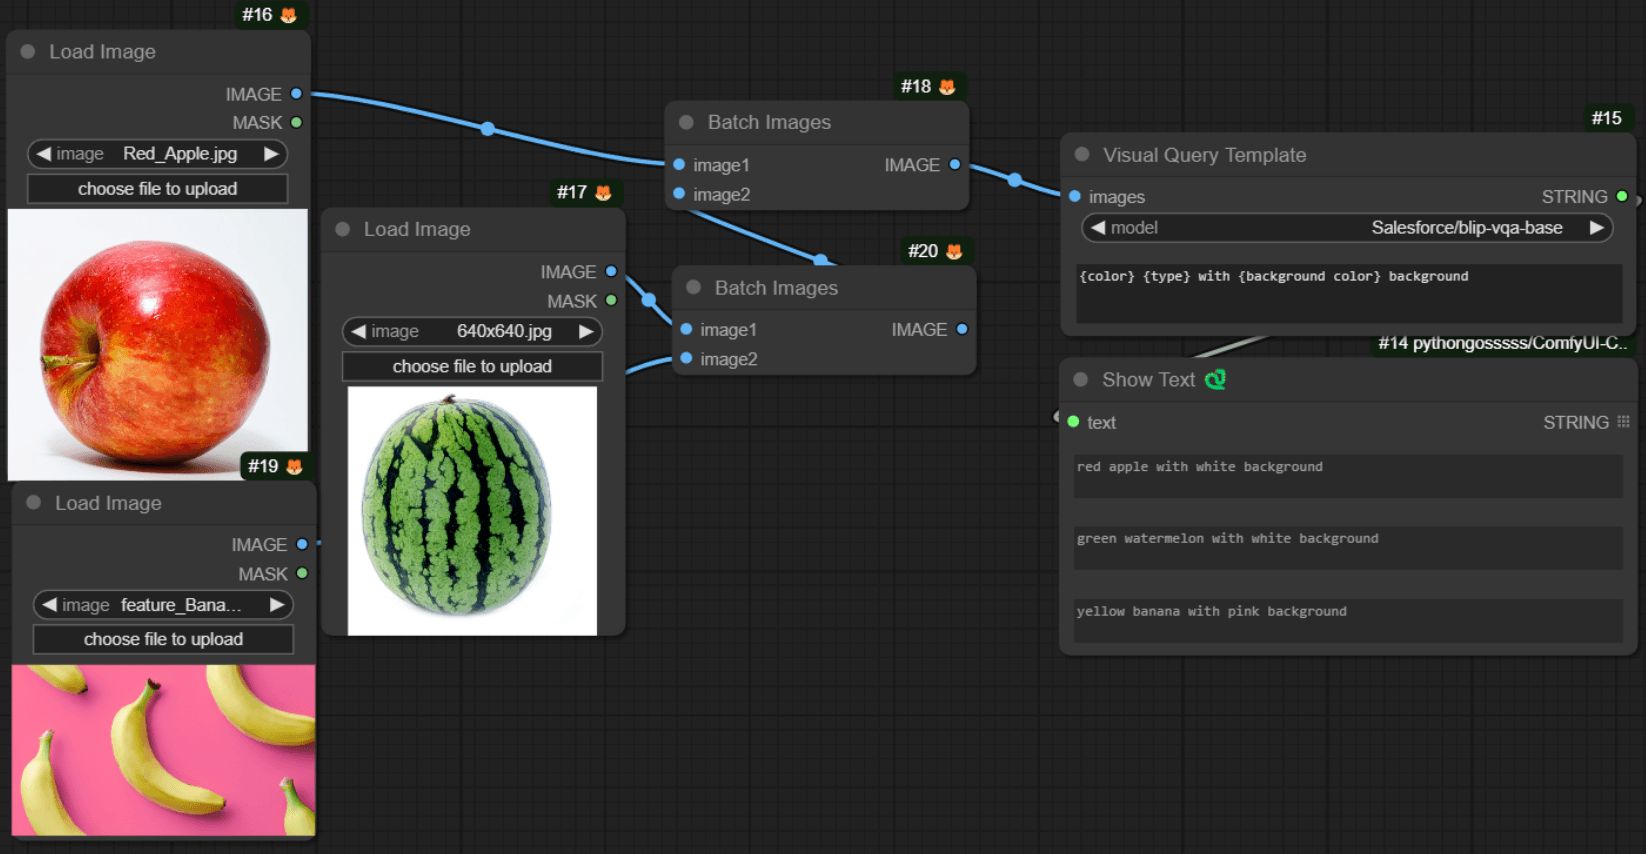
- ComfyUIがセットアップされていることを確認します
- このノードをワークフローに追加します
- 画像ソースを接続します
- モデルを選択します(不明な場合はデフォルトから始めてみてください)
- 質問テンプレートを作成します
- 実行して結果を確認します!
まるでレゴで遊ぶようなものです。ピースを組み合わせて、何が作れるか見てみるだけです。
よくある質問
Q:正確さはどの程度ですか? A:通常はかなり良好ですが、絶対的な信頼はできません。完璧な神託ではなく、役立つアシスタントのようなものです。
Q:商用プロジェクトで使用できますか? A:使用するAIモデルのライセンスを確認してください。一部は商用利用が許可されていますが、一部は許可されていません。
まとめ
開発者であれ、コンテンツクリエイターであれ、クールな技術で遊ぶのが好きな人であれ、このツールは無限の可能性を開きます。
ですから、試してみてはどうでしょうか? あなたの画像がどんなことを「語って」いるか、驚くかもしれません!
参照:https://github.com/celoron/ComfyUI-VisualQueryTemplate/tree/main
Related Posts
ComfyUI Luma AI API:シンプルガイド
驚くほど簡単に美しい動画を作成する方法をご紹介します。本ガイドでは、ComfyUI に Luma AI Dream Machine API を統合、インストール、活用する手順を詳しく解説します。今すぐ動画作成のプロセスを変革しましょう!
ComfyUI Snapshot Manager:カスタムノードと環境の管理
ComfyUIのカスタムノードと環境を整理しておくのが難しいですか?ComfyUIスナップショットマネージャーが必ずサポートしてくれます。
ComfyUIキーボードショートカット:今すぐワークフローを加速!
だらだらとしたワークフローにうんざりしていませんか?これらの画期的なComfyUIのキーボードショートカットが、あなたの生産性を飛躍的に高めてくれるでしょう。