Aplicaciones de IA
Elige un modelo de IA para comenzar
Generación de Videos
Generación de Imágenes
Generación de Audio
Seedance 2.0 Fast Imagen a Video
Genera videos cinematográficos a partir de una imagen de referencia con sincronización nativa de audio y video, preservación del sujeto y movimiento expresivo — optimizado para generación más rápida con 33% menos costo.
Entrada
Resultado
El contenido generado aparecerá aquí
Resultados de Ejemplo
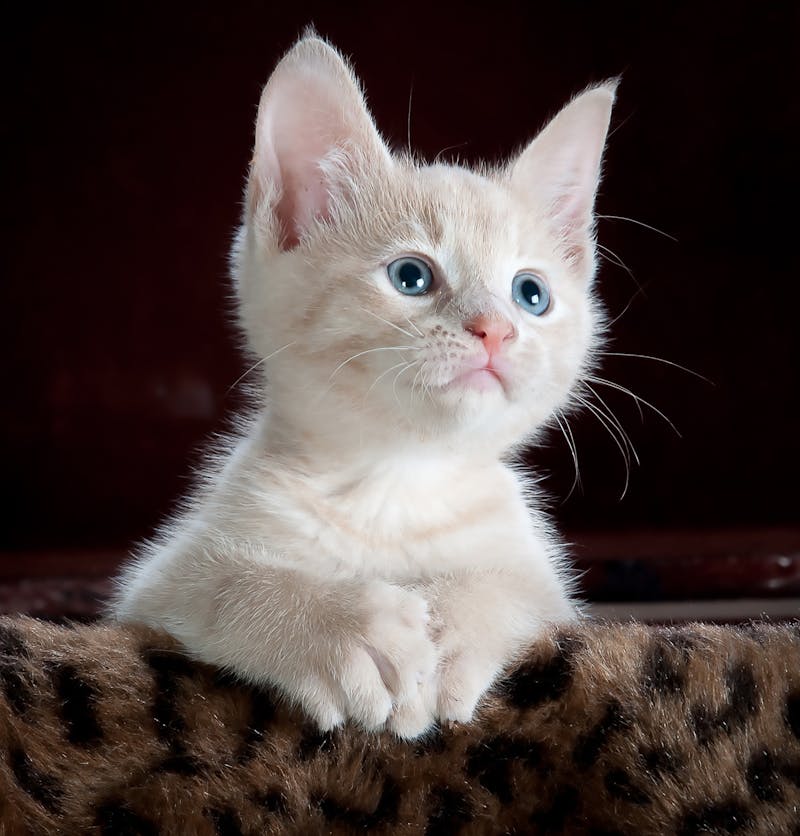
Generación de Video:
Reference image
Generación de Video:
The kitten slowly opens its eyes and stretches, yawning lazily, soft warm morning light
Preguntas Frecuentes
- ¿Qué formatos y tamaños de imagen funcionan mejor?
- Se admiten JPEG, PNG y WebP. Para mejores resultados, usa imágenes de al menos 720px en el lado más corto con sujetos claros y buena iluminación. El modelo maneja diversas resoluciones, pero JPEGs muy comprimidos (calidad < 50) o imágenes menores a 256px pueden producir artefactos. La relación de aspecto del video de salida coincide automáticamente con tu imagen de entrada.
- ¿Cómo decide el modelo qué movimiento añadir?
- El modelo combina tu imagen de referencia con el prompt de texto para determinar el movimiento. La imagen ancla la identidad visual (quién/qué y dónde), mientras el prompt impulsa la acción (qué sucede). Por ejemplo, subir un retrato y escribir 'ella gira para mirar sobre su hombro, el viento mueve su cabello' animará a esa persona específica con ese movimiento específico.
- ¿Cómo evitar que el modelo cambie la apariencia del sujeto?
- Seedance 2.0 Fast está diseñado para preservar el sujeto — mantiene rasgos faciales, ropa y composición consistentes con la entrada. Para maximizar la fidelidad: (1) usa una referencia de alta resolución y bien iluminada; (2) enfoca el prompt en movimiento, no en cambios de apariencia; (3) evita prompts que contradigan el contenido de la imagen.
- ¿Cuáles son los tiempos típicos de generación?
- Tiempos típicos: ~60–90 segundos para clips de 5s, ~120–180 segundos para clips de 10s, y ~180–300 segundos para clips de 15s. Los tiempos varían con la carga del servidor. La variante Fast procesa aproximadamente 2× más rápido que el Seedance 2.0 estándar.
- ¿Cuándo usar Imagen a Video vs. Texto a Video?
- Usa Imagen a Video cuando tengas una imagen específica para animar — fotos de productos, retratos, fotogramas de storyboard, o imágenes generadas por IA. Usa Texto a Video cuando partes de cero con solo una idea. Combinación potente: genera una imagen fija con un modelo de generación de imágenes, luego dale vida con Imagen a Video para máximo control creativo.
- ¿Puedo usar imágenes generadas por IA como entrada?
- Absolutamente. Este es uno de los flujos más populares — genera una imagen estática con Flux, Stable Diffusion o cualquier modelo de imágenes, y luego anímala con Seedance 2.0 Fast I2V. Esto te da control preciso sobre el estilo visual y el movimiento, y el modelo preserva fielmente la estética de la imagen generada por IA.
También te podría gustar
Ver todoGoogle Veo3.1 Lite Imagen a Vídeo
Transforma imágenes estáticas en vídeo cinematográfico 720p/1080p con Google Veo 3.1 Lite. Soporta relaciones de aspecto horizontal y vertical, control de prompt negativo y duración personalizable de hasta 8 segundos.
Google Veo3.1 Lite Texto a Vídeo
Genera vídeo cinematográfico en 720p/1080p a partir de descripciones de texto con Google Veo 3.1 Lite. Soporta relaciones de aspecto horizontal y vertical, control de prompt negativo y duración personalizable de hasta 8 segundos.
Seedance 2.0 API
El modelo de video IA de nueva generación de ByteDance: salida cinematográfica 2K, sincronización nativa audio-video, entrada multimodal con hasta 12 activos de referencia, narración multi-toma y sincronización labial en más de 8 idiomas — todo desde un solo prompt.