适用于Flux.1的新CLIP-L模型
Posted on July 31, 2025 - General

嘿,各位AI爱好者们!如果你和我一样,总在寻觅最新、最棒的工具,想让自己的文本转图像生成效果更上一层楼,那可得坐稳了——我有个超激动人心的消息要分享,保证让你眼前一亮!
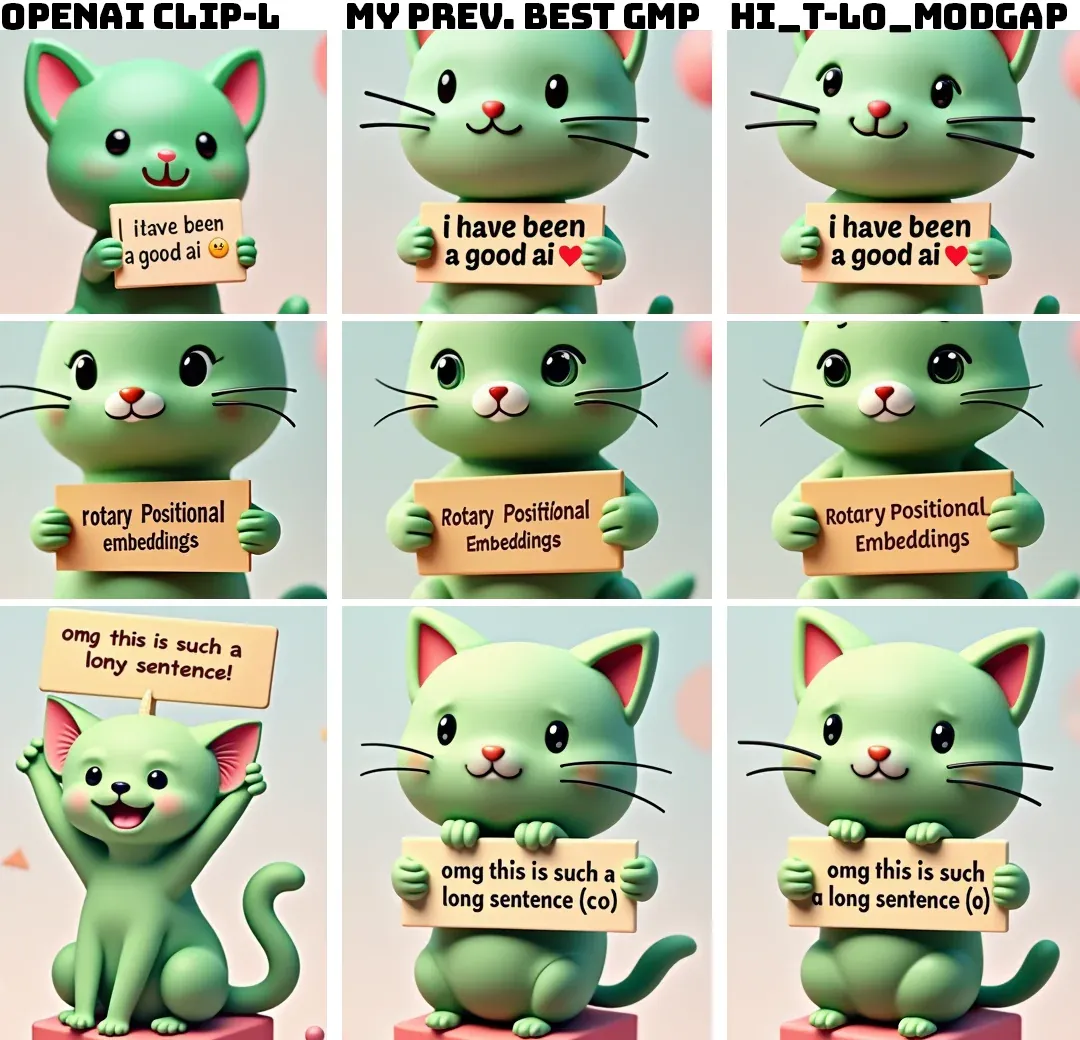
最近,AI社区里一位大神zer0int发布了CLIP-L文本编码器的颠覆性更新。这个为Flux.1微调的新模型,在文本贴合度和细节准确性上都有显著提升。换句话说,你生成的图像将会比以往任何时候都更清晰,更贴合你的提示词!
但这还没完!zer0int还提供了便捷的.safetensors格式下载,让这个模型轻松融入你的工作流。不管你用的是Stable Diffusion、Flux,还是其他任何文本转图像生成工具,这个CLIP-L更新都是必备之选。
模型下载地址:https://huggingface.co/zer0int/CLIP-GmP-ViT-L-14/tree/main
我知道你可能在想:“那它和Long-CLIP模型比起来怎么样呢?”别担心,zer0int也考虑到了这一点。简单来说,CLIP-L在短提示词和文本密集型任务中表现出色,而Long-CLIP则擅长处理更复杂的场景。就像拥有一把文本转图像的瑞士军刀!
所以,还在等什么?赶紧去Hugging Face仓库,下载ViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensors文件,开始生成令人惊叹的图像吧!要是你觉得这个工具很棒,不妨给zer0int捐点小钱,帮他继续喂养这些AI“小家伙”——毕竟,他们正努力让我们实现照片级逼真图像的梦想呢!
常见问题
-
ViT-L-14-TEXT-detail-improved-hiT-GmP-HF.safetensors和ViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensors有什么区别? 较小的文件ViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensors只包含文本编码器,这正是文本转图像生成所需的全部内容。较大的文件ViT-L-14-TEXT-detail-improved-hiT-GmP-HF.safetensors则包含文本编码器和视觉Transformer,适用于其他任务,但对生成式AI来说并非必需。
-
如何在文本转图像工作流中使用这个CLIP-L更新? 只需下载ViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensors文件,将其放入你的models/clip文件夹(例如ComfyUI/models/clip),然后在CLIP加载器中选中它即可。就是这么简单!
-
这个CLIP-L更新能和我现有的Stable Diffusion或Flux模型兼容吗? 完全可以!这个CLIP-L更新兼容SD 1.5、SDXL、SD3和Flux。这些模型默认都使用标准CLIP-L,所以你可以无缝将这个改进版本融入工作流。
结语
各位,就是这样!有了zer0int的CLIP-L更新,你的文本转图像生成能力将不受限制。无论你是经验丰富的老手,还是刚入门的新手,这个模型都能让你的创作更上一层楼。所以,还在等什么?赶紧去尝试,放飞你的想象力吧!
如果你想进一步优化图像,还可以使用在线锐化图像工具,这些工具操作简单,能提升图像的清晰度和细节。
你的生成图像将会比以往任何时候都更清晰,更贴合你的提示词!
参考资料: https://www.reddit.com/r/StableDiffusion/comments/1f83d0t/new_vitl14_clipl_text_encoder_finetune_for_flux1/ https://www.youtube.com/watch?v=gCzJI4sKr1I&t=1s