Flux.1向け新CLIP-Lモデル
Posted on July 31, 2025 - General

こんにちは、AI愛好家の仲間たち!もし君が私と同じような人なら、テキストから画像を生成する技術をさらに向上させるため、最新かつ最高のツールを常に探しているはずだ。さあ、腰をしっかりつけてもらいたい。今から紹介するニュースは、きっと君の心を驚かせるぞ!
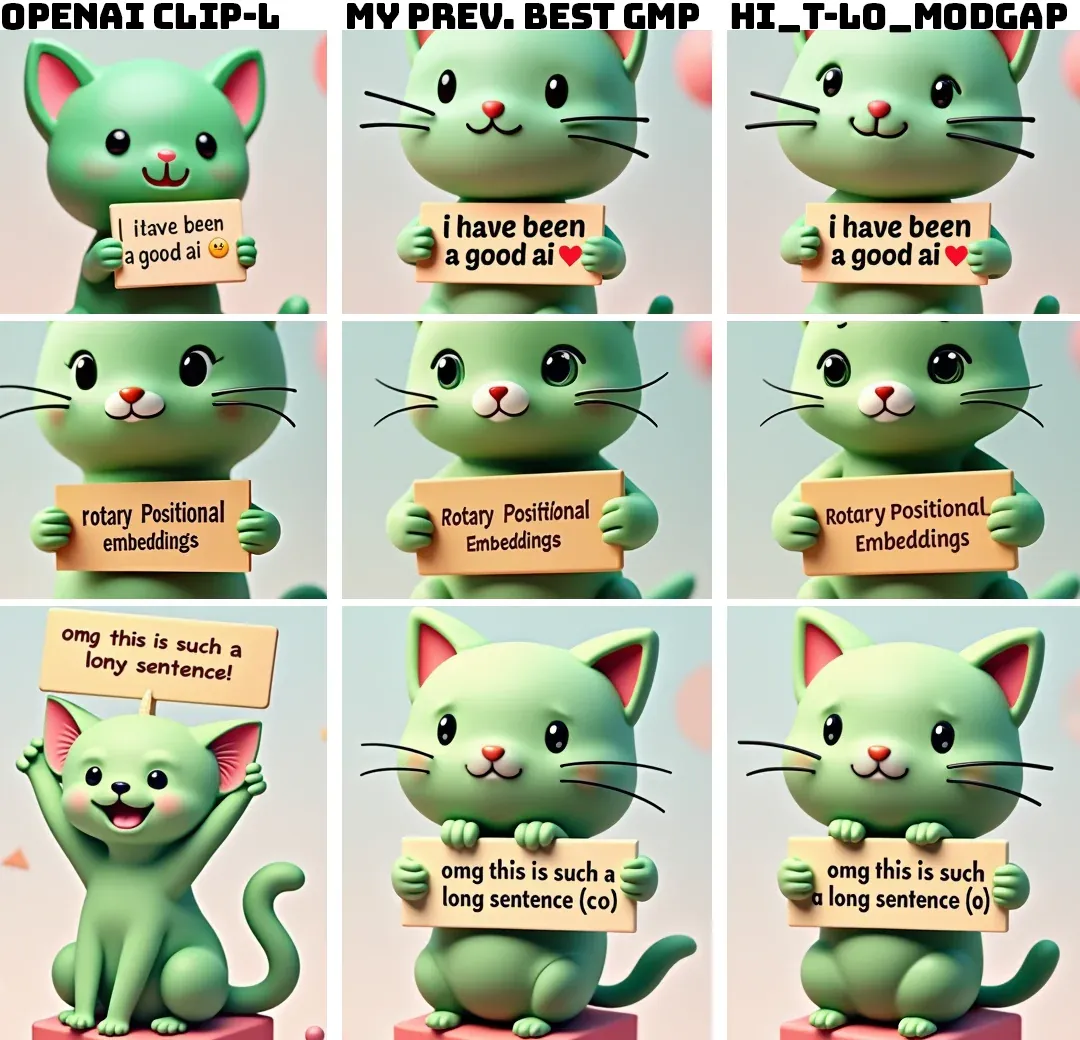
最近、AIコミュニティの俊英であるzer0intが、CLIP-Lテキストエンコーダの画期的なアップデートをリリースしました。この新しいモデルはFlux.1用に微調整されており、テキストの忠実性と細部の正確性が向上しています。つまり、生成される画像はこれまで以上に鮮明になり、プロンプトの内容をより正確に再現するようになるのです!
しかし、これだけではありません!zer0intは使いやすい.safetensors形式のダウンロードも提供しているので、このモデルをワークフローに簡単に統合できます。Stable Diffusion、Flux、その他どんなテキスト-to-画像生成ツールを使っていても、このCLIP-Lのアップデートは必携です。
モデルのダウンロード先:https://huggingface.co/zer0int/CLIP-GmP-ViT-L-14/tree/main
さて、君はこんな風に思っているだろう:「でも、Long-CLIPモデルと比べたらどうなの?」それについてもzer0intは考えています。簡単に言うと、CLIP-Lは短いプロンプトやテキストが多いタスクで優れた性能を発揮し、Long-CLIPはより複雑なシーンの処理に長けています。まるでテキスト-to-画像モデルのスイスアーミーナイフのようなものです!
だから、何を待っているのか?さっそくHugging Faceのリポジトリにアクセスし、ViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensorsファイルをダウンロードして、驚くべき画像生成を始めましょう!もし気分がよければ、zer0intに少しでも寄付をしてみてはどうでしょうか。これによって、彼らがAIの研究開発を続ける助けになります。結局のところ、彼らは我々のフォトリアルisticな画像の夢を実現するために一生懸命働いているのですから!
よくある質問(FAQ)
-
ViT-L-14-TEXT-detail-improved-hiT-GmP-HF.safetensorsとViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensorsの違いは何ですか? サイズの小さいファイルであるViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensorsには、テキスト-to-画像生成に必要なテキストエンコーダのみが含まれています。サイズの大きいファイルであるViT-L-14-TEXT-detail-improved-hiT-GmP-HF.safetensorsには、テキストエンコーダとビジョントランスフォーマーの両方が含まれています。これは他のタスクには有用ですが、生成AIには必要ではありません。
-
テキスト-to-画像のワークフローでこのCLIP-Lアップデートをどのように使えばよいですか? ViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensorsファイルをダウンロードし、models/clipフォルダ(例:ComfyUI/models/clip)に配置して、CLIPローダーで選択するだけです。それだけで簡単に使えます!
-
このCLIP-Lアップデートは既存のStable DiffusionやFluxモデルと相性が良いですか? もちろんです!このCLIP-LアップデートはSD 1.5、SDXL、SD3、Fluxと互換性があります。これらのモデルはデフォルトで標準のCLIP-Lを使用しているため、この改良版をシームレスにワークフローに統合できます。
まとめ
以上が全てです、皆さん!zer0intのCLIP-Lアップデートによって、テキスト-to-画像生成の可能性は無限大です。経験豊富なプロであっても、初心者であっても、このモデルは必ず君の創作物をさらなる高みへと引き上げてくれるでしょう。だから、何を待っているのか?さっそく試して、想像力を解き放ってみましょう!
さらに画像を洗練させたい場合は、オンラインで画像を鮮明にするツールを使うこともできます。これらのツールは使いやすく、画像の鮮明度と細部を向上させてくれます。
生成される画像は、これまで以上に鮮明になり、プロンプトの内容をより正確に再現するようになるでしょう!
出典: https://www.reddit.com/r/StableDiffusion/comments/1f83d0t/new_vitl14_clipl_text_encoder_finetune_for_flux1/ https://www.youtube.com/watch?v=gCzJI4sKr1I&t=1s
Related Posts
Web UI vs Comfy UI:AI描画の初心者はどちらを選べば良いか?
この記事では、AI画像生成に使用される2つの人気ツールであるWeb UIとComfy UIを比較・対比しています。両者の共通点、背景、利点、欠点について探り、AI描画の初心者が自分のニーズに最も適したツールを決めるのを助けることを目的としています。

FluxGym:フラックスローラのための低VRAMトレーニングGUI
FluxGymは、低VRAM(12GB/16GB/20GB)に対応したコンピューターでユーザーがFlux LoRAsをトレーニングできるようにするオープンソースのウェブUIであり、高度なフィットネス技術をすべての人が利用できるようにしています。