ComfyUI 基礎入門:初心者向けシンプルガイド
Posted on July 30, 2025 - Tutorials
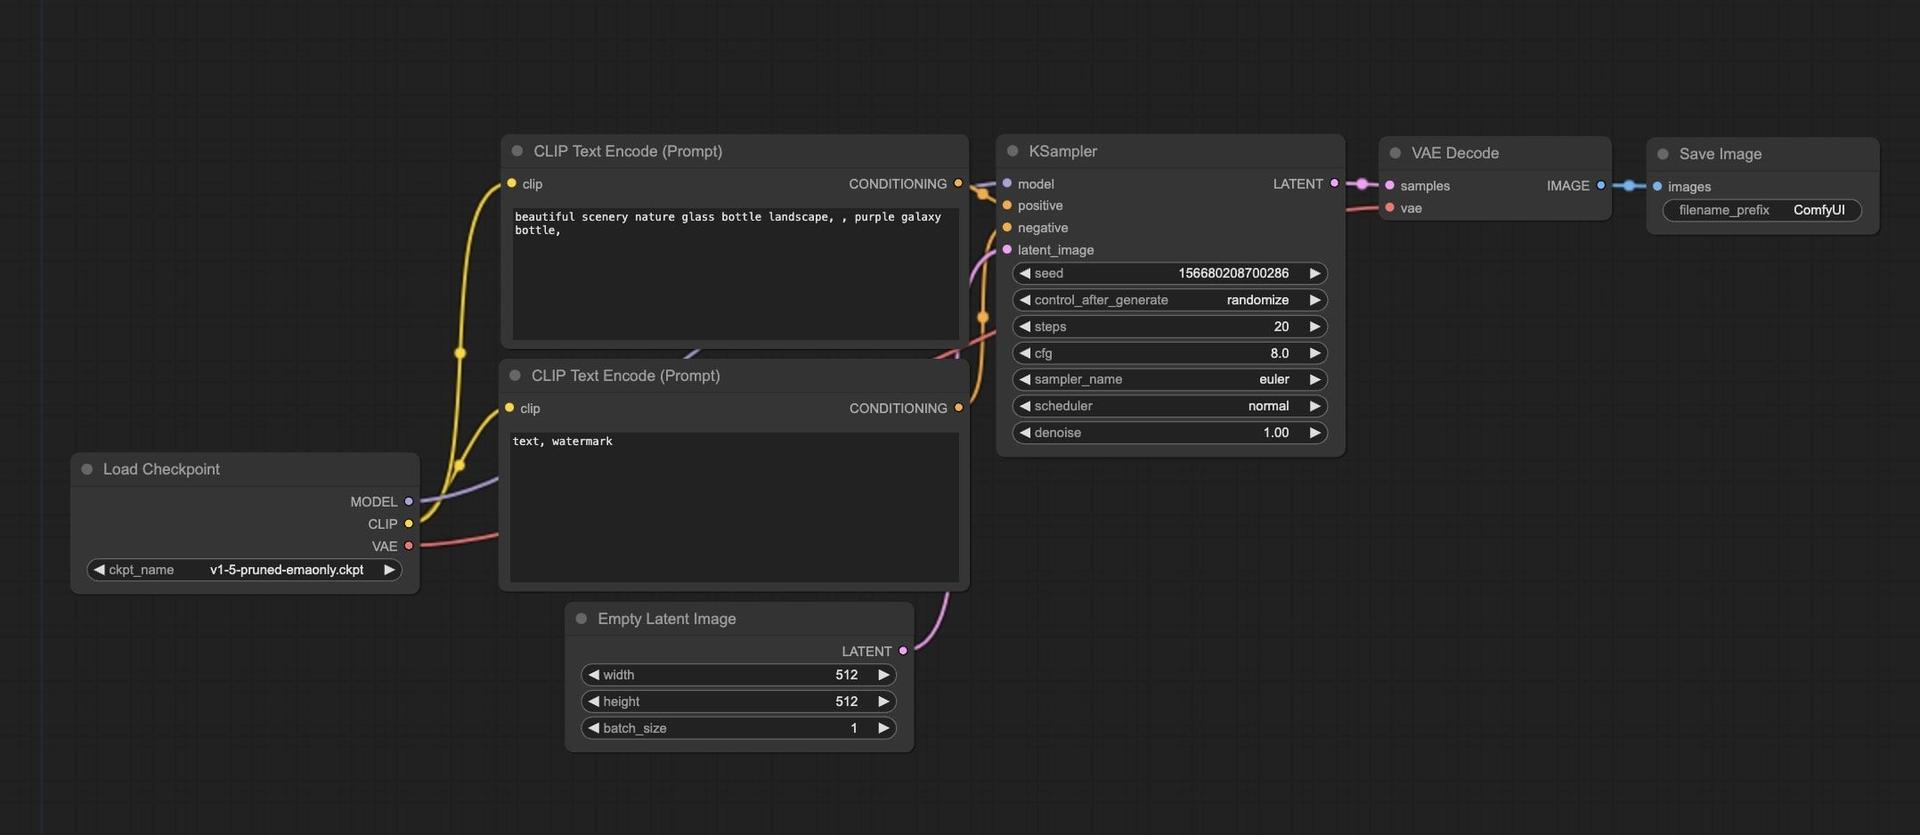
やあ!ComfyUI の世界で迷子になってる?心配無用。僕も同じ道を通ってきたから、分かりやすく解説するよ。
UNET(ユーネット)って何?
UNET は ComfyUI の“頭脳”みたいなもの。魔法を起こすメインモデルだよ。
UNET を超賢いアーティストだと思ってみて。アイデアを渡すと、それを“絵”にしてくれる。ただし筆の代わりに数学を使うんだ。すごいでしょ?
しかも UNET は少ないサンプルから学ぶのが得意。まるでアートスタイルを写真のように記憶してるみたいなんだ。
名前の通り、モデル構造は大きく「U」の形をしている。この形のおかげで全体像も細部も同時に覚えられるんだよ。
VAE:画像の圧縮マシン
VAE は “Variational AutoEncoder” の略だけど、ここでは「画像スクイーザー」と呼ぼう。
大きくて高解像度な画像を「潜在空間(latent space)」っていう領域にギュッと押し込むイメージ。大きなハンバーガーをミニバーガーに潰す感じだね。
ただしこの圧縮は「ロスあり」。ピクルスが一枚抜け落ちるかもしれない。そのため、大画像と圧縮画像を行ったり来たりすると品質が落ちやすいから注意してね。
CLIP:テキスト→画像の翻訳官
CLIP はモデルに指示を与える“言葉の翻訳者”。「こういう絵が欲しい」と伝えると、UNET が理解できる形に変換してくれる。
コツ①:プロンプトの先頭に重要なキーワードを置くと、より強く反映されるよ。 コツ②:プロンプト内の各パートに対する重み(“聞く度合い”)も調整できるから、重要度を音量のように上げ下げしてみて。
テンソル(Tensors):データの小分けパック
ちょっとテクい言葉だけど、テンソルは「特定の形で並べられた数字のかたまり」に過ぎない。
ComfyUI ではほぼ全てがテンソル。画像もプロンプトも中間データも全部テンソルなんだ。
テンソルの形状を見たいときは「Tensor Shape Debug」ツールを使おう。[1, 768, 512, 3] みたいに表示されるけど、慌てなくて大丈夫。画像の高さ・幅・チャンネル数を示しているだけだからね。
ここからさらに深掘り!
チェックポイント:お得なセットメニュー
コンボセットみたいに、UNET・CLIP・VAE がひとまとめになっているのがチェックポイント。 ハンバーガー(UNET)、ポテト(CLIP)、ドリンク(VAE)が一度に楽しめる感じ。
でも「ポテトだけ食べたい」ってときはローダーノードで個別に呼び出せる。好きなものだけ選べるのが便利!
潜在空間:画像縮小マシン
超高解像度の愛犬写真をミニチュアにするのが潜在空間への圧縮プロセス。見た目は残るけど、耳の形が少し変わるかも。
この縮小は VAE が担当するよ。サイズは8の倍数にしておくと画質が崩れにくいから覚えておこう。
プロンプト条件付け:クリエイティブ・カクテル
プロンプト条件付けはアイデアを“調合”するようなもの。方法は3種類:
- Concat(連結):素材を順番に重ねるだけ。
- Combine(結合):別々に作ったミニカクテルを混ぜる。
- Average(平均化):全素材をミックスして一体化。
それぞれ味わいが変わるから、好みの調合方法を見つけてみて。
条件付けタイムスタンプ:時間制御トリック
凄いテク:生成プロセスのどのタイミングでどのプロンプトを使うか指定できるんだ。
例:「最初の20%は“春の村”プロンプトで、その後は“冬の村”プロンプトに切り替えてね」なんてことも可能。まるで時空と天気を同時に操るような体験!
モデル訓練解像度:最適なサイズ
AIモデルごとに最も得意な解像度がある。 例えば SDXL は 1024×1024 に特化して訓練されているから、それより小さいと性能を十分に発揮できないことも。
いろいろ試したいときは種子(seed)を 0 にすると、毎回ランダムに新しい結果を楽しめるよ。
サンプラー & スケジューラー:芸術の指揮者と演奏者
サンプラー(Sampler)とスケジューラー(Scheduler)は、オーケストラの指揮者と楽団員のように連携して画像を生成する要。
- Predictable(予測可能): euler、dpmpp_2m、ddim、uni_pc… クラシック音楽みたいに安定的。
- Stochastic(確率的): ジャズみたいに即興的で意外性あり。
まずはこれらを試してみて:
- Schedulers: karras、exponential、sgm_uniform、normal
- Samplers: euler、dpmpp_2m、uni_pc、dmpp_2m_sde_ddpm、dpm_adaptive
ステップ数(Steps):じっくり派 or さくっと派
ステップ数を増やせば画質は上がるけど時間がかかる、減らせば速いけど質は落ちる。 まるでシチューを煮込むように、時間が味を深めるんだ。
ComfyUI はゼロから作るんじゃなく、「ノイズの塊から少しずつ像を彫り出す」ようなイメージだよ。
CFG(Classifier-Free Guidance):AIの相棒ナビ
CFG は AI の “副ドライバー” みたいなもの:
- 高 CFG:ガチガチに指示通り動く“厳しめナビ”。
- 低 CFG:ゆるっと寄り道もOKな“ゆるナビ”。
商品画像みたいに正確性が必要なら高め、意外性を楽しみたいときは低めにしてみて。
ランダムシード:秘密の鍵
ランダムシードは毎回同じ絵を再現するための“鍵”。 シード、プロンプト、設定を同じにすれば、いつでも同じ結果が得られる。
「この画像の雰囲気は好きだけど、少し色味だけ変えたい…」なんてときに重宝するよ。
こんな感じで盛りだくさんの ComfyUI 基礎知識!最初は情報量が多いけど、手を動かして遊んでみるのが一番の近道だよ。実際に試してみれば、いつの間にか楽しくなっているはず!
フィードバックはいつでも [email protected] までどうぞ!
Related Posts

How to train flux lora using comfyui on vast.ai?
Learn how to train your own LoRA model with FLUX.1 in this step-by-step guide. Perfect for beginners, includes GPU setup, dataset preparation, and expert tips.

How I Use SkyReels-A2 To Create Amazing AI Videos With Multiple Reference Objects
Discover how SkyReels-A2 is changing the game for video creators by allowing you to combine multiple reference images into one seamless video.