Comfyui 视觉查询模板节点:用于精确控制
Posted on August 4, 2025 - Comfyui

这个ComfyUI节点借助智能AI模型将图片转换成文字。就好比有一个机器人,能描述出它在你的照片中看到的内容。
这个节点是做什么的?
你是否曾希望电脑能告诉你图片里有什么?这正是这个ComfyUI节点的功能。
它利用一种名为视觉问答(VQA)的技术来分析图像,并回答关于图像的问题。
最酷的是:你不必逐个提问。只需设置一个模板,AI就会自动填补空白。
例如,你可以这样提问: “{眼睛颜色}的眼睛,{发型}的{头发颜色}头发,{种族} {性别},{年龄}岁”
AI分析图片后可能会给出这样的答案: “棕色的眼睛,黑色的卷发,亚裔女性,25岁”
这就像有一个超级聪明的朋友,特别擅长描述照片。
它是如何工作的?
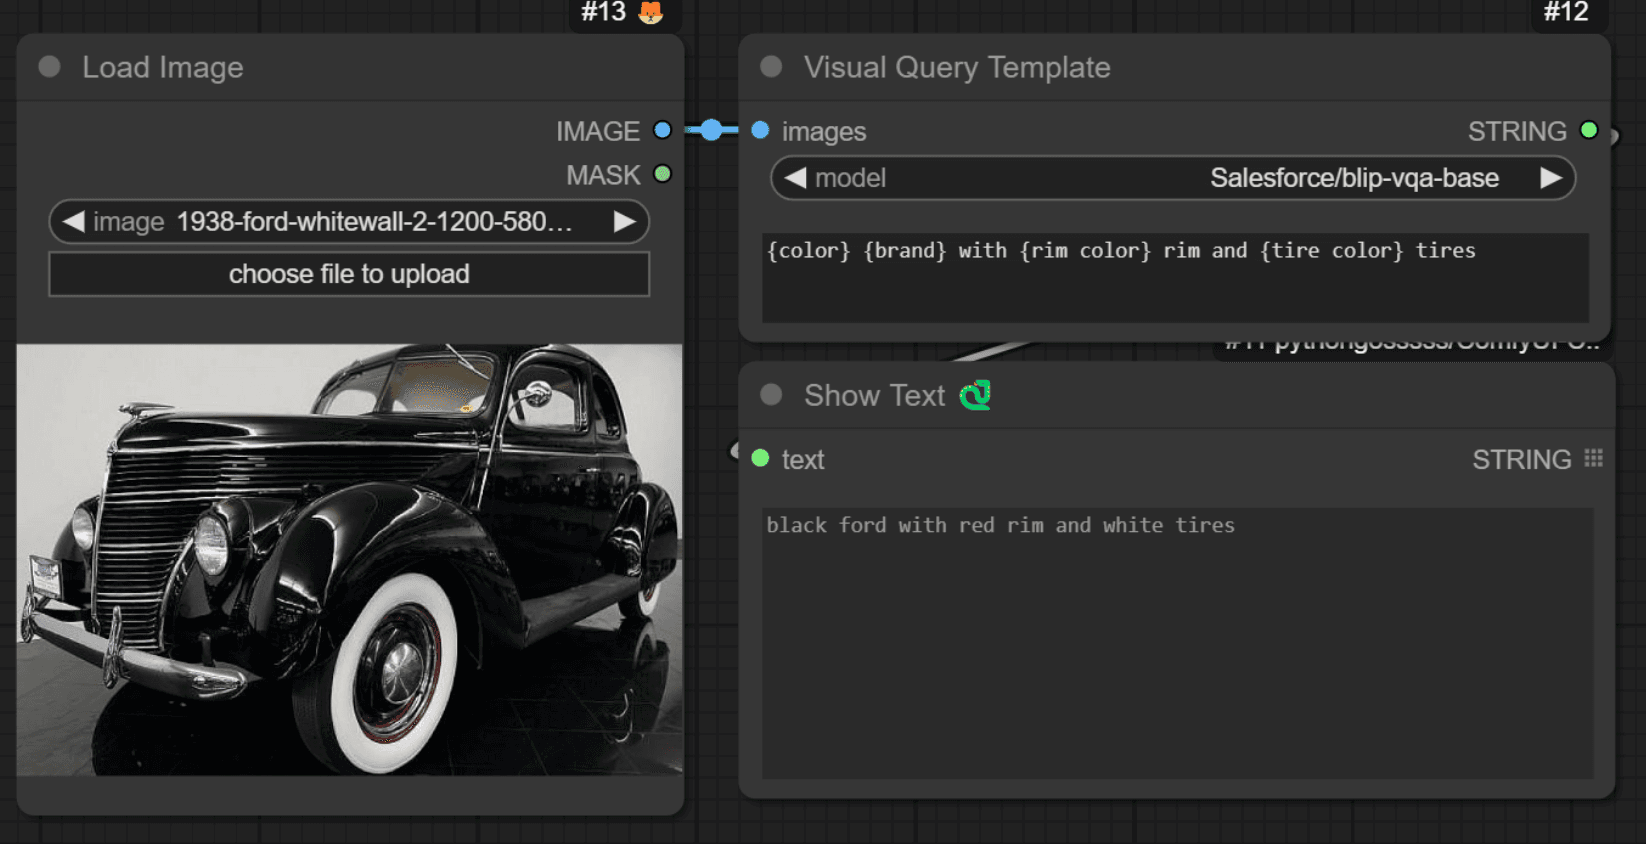
我们来一步步拆解:
- 你给它一些图片
- 选择一个AI模型(它提供了几个选项供选择)
- 编写一个带有花括号{}内问题的模板
- 节点开始发挥作用
- 为每张图片输出对应的描述
就是这么简单,无需成为技术专家也能使用。
为什么要使用它?
原因有很多:
- 为视障人士描述照片内容
- 快速整理大量图片
- 让图像数据库可搜索
- 为社交媒体帖子生成 caption
- 分析照片中的时尚趋势
- 辅助网购(想象一下能自动描述衣物)
其应用可能性几乎是无限的。
技术细节(别担心,我们会讲得很简单)
这个节点基于一些巧妙的技术:
- 它使用来自Hugging Face的AI模型(Hugging Face就像AI的超市)
- 它能兼容不同类型的VQA模型(BLIP、ViLT、GIT等)
- 它会将计算机图像数据转换成AI能理解的常规图片
- 它能记录处理所需的时间(在你赶时间时很有用)
但最棒的是:你无需理解这些也能使用它。它就是能正常工作。
如何开始使用
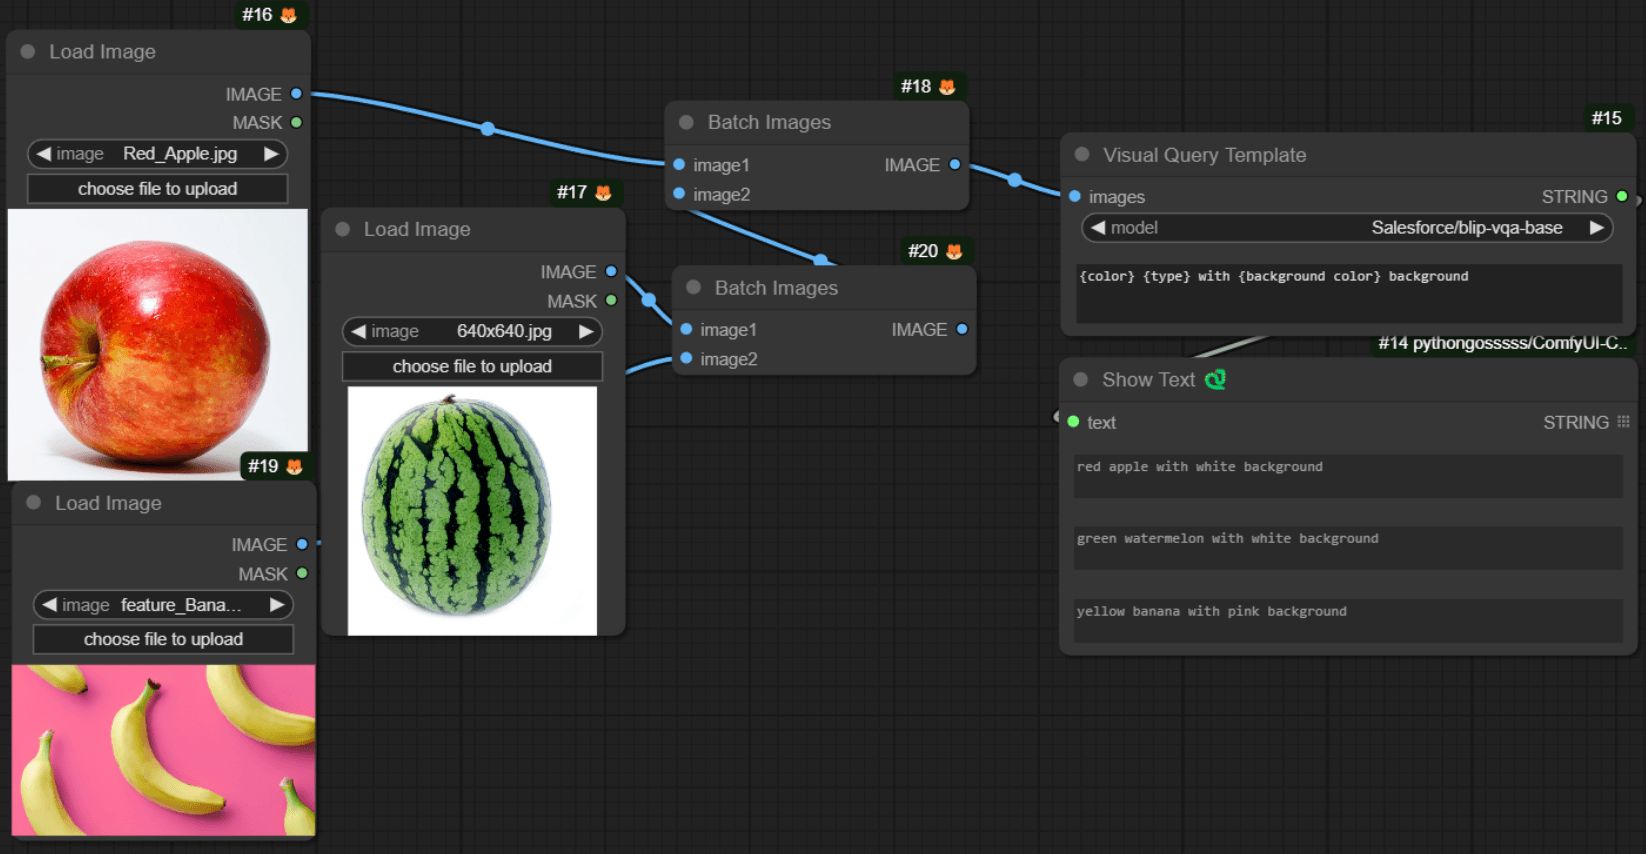
- 确保你已经安装配置好ComfyUI
- 将此节点添加到你的工作流中
- 连接一个图像源
- 选择一个模型(如果你不确定,就从默认模型开始)
- 编写你的问题模板
- 运行它,看看结果!
这就像玩乐高积木。你只需把零件拼在一起,看看能创造出什么。
常见问题
问:它的准确性如何? 答:通常来说很不错,但也别把它当成绝对可靠的。它更像是一个有帮助的助手,而不是完美的神谕。
问:我可以将它用于商业项目吗? 答:请查看你所使用的AI模型的许可证。有些允许商业使用,有些则不允许。
总结
无论你是开发者、内容创作者,还是只是喜欢摆弄酷炫技术的人,这个工具都为你开启了无限可能。
所以为什么不试试呢?你可能会惊讶于你的图片能“说”出这么多内容!
参考资料:https://github.com/celoron/ComfyUI-VisualQueryTemplate/tree/main
Related Posts
ComfyUI Luma AI API:简单指南
轻松制作令人惊艳的视频。我们的指南将教你如何在 ComfyUI 中集成、安装和使用 Luma AI Dream Machine API。今天就开始改变你的 视频创作流程吧!
ComfyUI快照管理器:管理自定义节点和环境
难以保持你的ComfyUI自定义节点和环境有序吗?ComfyUI快照管理器会为你保驾护航。
ComfyUI键盘快捷键:立即加速你的工作流程!
厌倦了拖沓的工作流程?这些极具颠覆性的ComfyUI键盘快捷键将让你的工作效率飙升。

ComfyUI-CogVideoXWrapper:借助AI将文本转化为视频
ComfyUI-CogVideoXWrapper是一款工具,可让您在ComfyUI中使用CogVideoX模型。ComfyUI-CogVideoXWrapper支持以下CogVideoX模型:CogVideoX-5b、CogVideoX-Fun、CogVideoX-5b-I2V