Новая модель CLIP-L для Flux.1
Posted on August 5, 2025 - General

Привет, соратники-энтузиасты ИИ! Если ты похож на меня, то всегда ищешь самые свежие и лучшие инструменты, чтобы поднять генерацию изображений из текста на новый уровень. Что ж, приготовься — у меня есть потрясающая новость, которая тебя потрясёт!
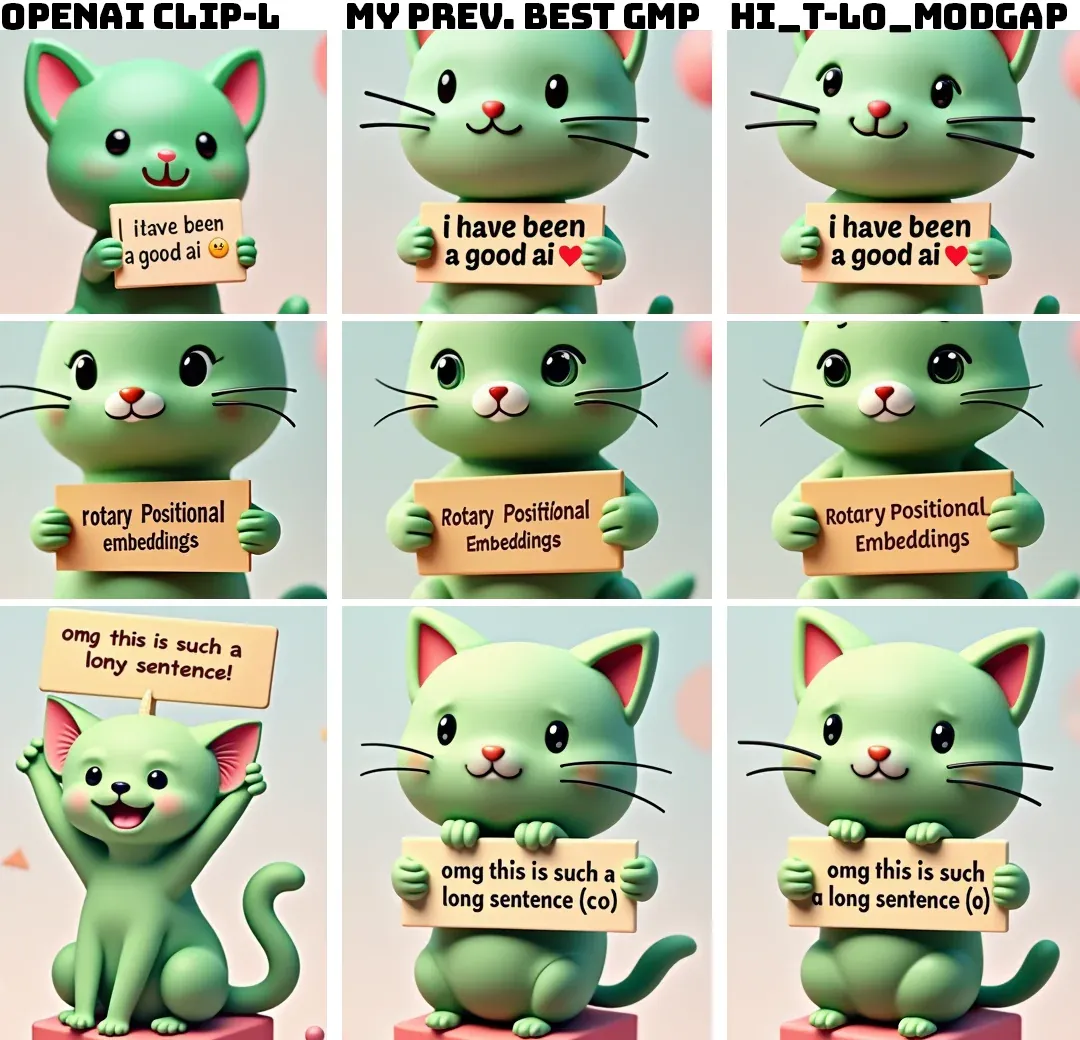
Недавно талантливый представитель сообщества ИИ по имени zer0int выпустил революционное обновление текстового энкодера CLIP-L. Этот новый модель, финитюнированный для Flux.1, обладает улучшенной точностью соответствия тексту и детализацией. Иными словами, генерируемые тобой изображения станут более чёткими и точными по отношению к подсказкам, чем когда-либо прежде!
Но это ещё не всё! zer0int также предоставил удобную загрузку в формате .safetensors, что делает интеграцию этой модели в твой рабочий процесс простым и быстрым. Независимо от того, используешь ли ты Stable Diffusion, Flux или любой другой генератор изображений из текста, это обновление CLIP-L обязательно должно быть в твоём арсенале.
Скачать модель можно здесь: https://huggingface.co/zer0int/CLIP-GmP-ViT-L-14/tree/main
Я знаю, что ты сейчас думаешь: «Но как он сравнивается с моделью Long-CLIP?» zer0int тоже позаботился об этом. Коротко говоря, CLIP-L отличается в работе с короткими подсказками и задачами, богатых текстом, тогда как Long-CLIP лучше справляется с более сложными сценами. Это как нож-швейцарский нож для моделей генерации изображений из текста!
Так что чего ты ждёшь? Перейди в репозиторий Hugging Face, загрузи файл ViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensors и начни генерировать потрясающие изображения! А если ты чувствуешь желание помочь, рассмотри возможность отправить zer0int немного денег — это поможет ему продолжать работу над этими ИИ-«сущностями», которые трудятся, чтобы воплотить наши мечты о фотоподобных изображениях в реальность!
Часто задаваемые вопросы (FAQ)
-
В чём разница между ViT-L-14-TEXT-detail-improved-hiT-GmP-HF.safetensors и ViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensors? Меньший файл ViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensors содержит только текстовый энкодер — всё, что нужно для генерации изображений из текста. Больший файл ViT-L-14-TEXT-detail-improved-hiT-GmP-HF.safetensors включает как текстовый энкодер, так и визуальный трансформер, который полезен для других задач, но не необходим для генеративного ИИ.
-
Как использовать это обновление CLIP-L в моём рабочем процессе генерации изображений из текста? Просто загрузи файл ViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensors, помести его в папку models/clip (например, ComfyUI/models/clip) и выбери его в загрузчике CLIP. Это так просто!
-
Сработает ли это обновление CLIP-L с моими существующими моделями Stable Diffusion или Flux? Конечно! Это обновление CLIP-L совместимо с SD 1.5, SDXL, SD3 и Flux. Все эти модели по умолчанию используют стандартный CLIP-L, так что ты можешь бесшовно интегрировать эту улучшенную версию в свой рабочий процесс.
Заключение
Вот и всё, друзья! С обновлением CLIP-L от zer0int у генерации изображений из текста нет ограничений. Независимо от того, опытный профессионал ты или только начинаешь, эта модель непременно поднимет твои творения на новый уровень. Так что чего ждёшь? Иди, экспериментируй и отпусти свою фантазию!
Если ты хочешь ещё больше улучшить свои изображения, можешь также на sharpen image online с помощью простых в использовании инструментов, которые повышают чёткость и детализацию.
Твои генерируемые изображения станут более чёткими и точными по отношению к подсказкам, чем когда-либо прежде!
Источники: https://www.reddit.com/r/StableDiffusion/comments/1f83d0t/new_vitl14_clipl_text_encoder_finetune_for_flux1/ https://www.youtube.com/watch?v=gCzJI4sKr1I&t=1s