Nuevo modelo CLIP-L para Flux.1
Posted on July 31, 2025 - General

¡Hola, compañeros entusiastas de la IA! Si eres como yo, siempre estás buscando las últimas y mejores herramientas para llevar tus generaciones de texto a imagen al siguiente nivel. Bueno, afírmate porque tengo una noticia emocionante que te va a dejar boquiabierto/a!
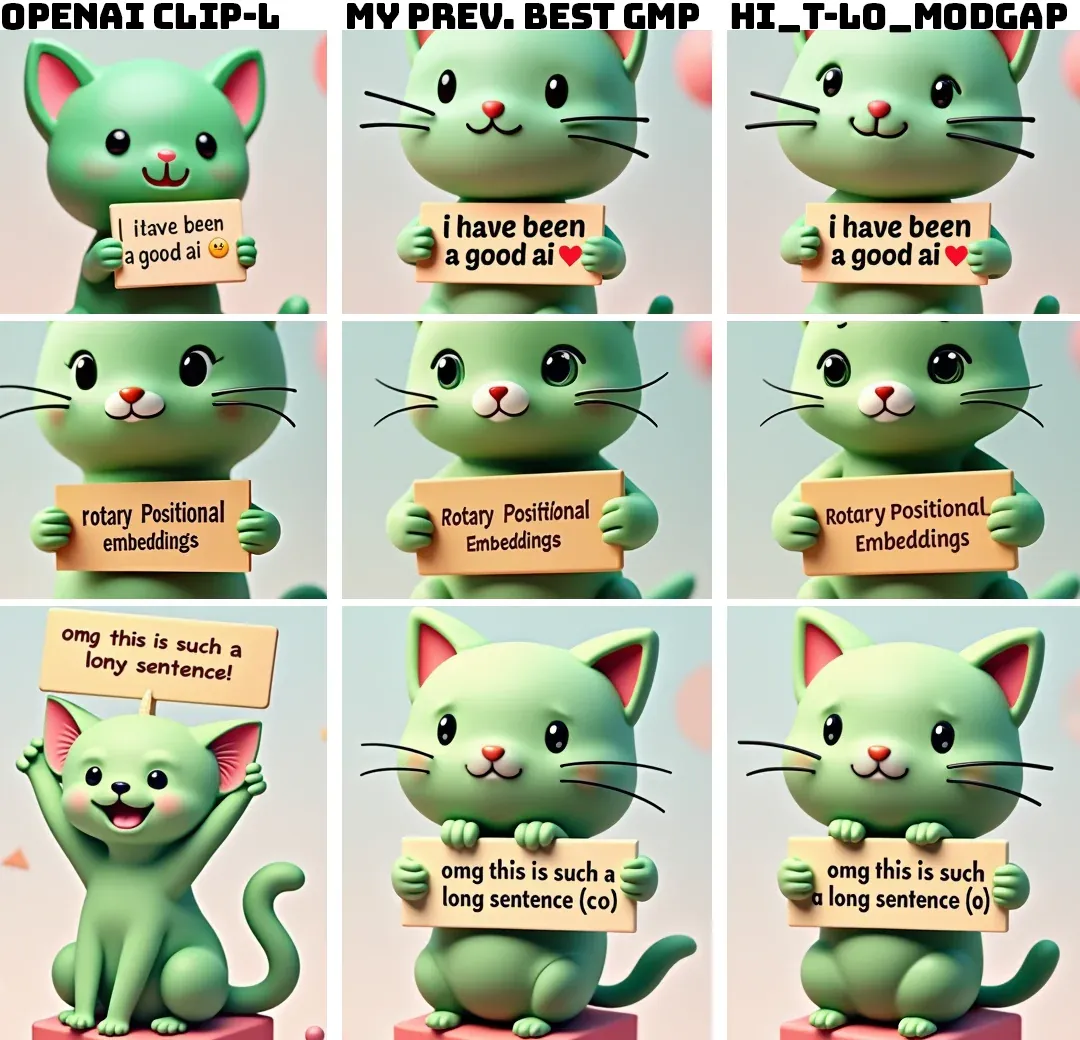
Recientemente, una mente brillante de la comunidad de IA, zer0int, ha lanzado una actualización revolucionaria para el codificador de texto CLIP-L. Este nuevo modelo, afinado para Flux.1, se enorgullece de una mejor adherencia al texto y precisión en los detalles. En otras palabras, tus imágenes generadas van a lucir más nítidas y más fieles a tus prompts que nunca!
Pero espera, hay más! zer0int también ha proporcionado una descarga conveniente en formato .safetensors, lo que hace que integrar este modelo en tu flujo de trabajo sea pan comido. Ya sea que uses Stable Diffusion, Flux o cualquier otro generador de texto a imagen, esta actualización de CLIP-L es imprescindible.
Puedes descargar el modelo aquí: https://huggingface.co/zer0int/CLIP-GmP-ViT-L-14/tree/main
Ya sé lo que estás pensando: "Pero ¿cómo se compara con el modelo Long-CLIP?". Pues zer0int también tiene la respuesta para eso. En resumen, CLIP-L brilla en prompts más cortos y tareas con mucho texto, mientras que Long-CLIP sobresale en el manejo de escenas más elaboradas. ¡Es como tener un cuchillo suizo de modelos de texto a imagen!
¿Así que qué estás esperando? Ve al repositorio de Hugging Face, descarga el archivo ViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensors y empieza a generar imágenes impresionantes! Y si te sientes generoso/a, considera donar unos cuantos dólares a zer0int para ayudar a mantener a esas criaturas de IA contentas y alimentadas. Después de todo, están trabajando duro para hacer realidad nuestros sueños de imágenes fotorrealistas!
Preguntas frecuentes (FAQ)
-
¿Cuál es la diferencia entre ViT-L-14-TEXT-detail-improved-hiT-GmP-HF.safetensors y ViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensors? El archivo más pequeño, ViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensors, contiene solo el codificador de texto, que es todo lo que necesitas para la generación de texto a imagen. El archivo más grande, ViT-L-14-TEXT-detail-improved-hiT-GmP-HF.safetensors, incluye tanto el codificador de texto como el transformador de visión, que es útil para otras tareas pero no necesario para la IA generativa.
-
¿Cómo uso esta actualización de CLIP-L en mi flujo de trabajo de texto a imagen? Simplemente descarga el archivo ViT-L-14-TEXT-detail-improved-hiT-GmP-TE-only-HF.safetensors, colócalo en tu carpeta models/clip (por ejemplo, ComfyUI/models/clip) y selecciónalo en tu cargador de CLIP. ¡Es así de fácil!
-
¿Funcionará esta actualización de CLIP-L con mis modelos existentes de Stable Diffusion o Flux? ¡Absolutamente! Esta actualización de CLIP-L es compatible con SD 1.5, SDXL, SD3 y Flux. Todos estos modelos usan el CLIP-L estándar por defecto, por lo que puedes integrar esta versión mejorada sin problemas en tu flujo de trabajo.
Conclusión
¡Ahí lo tienes, gente! Con la actualización de CLIP-L de zer0int, los límites son el cielo cuando se trata de tus generaciones de texto a imagen. Ya sea que seas un profesional experimentado o estés empezando, este modelo seguramente llevará tus creaciones a nuevas alturas. ¿Así que qué estás esperando? Sal, experimenta y deja volar tu imaginación!
Si buscas refinar tus imágenes aún más, también puedes afilitar imágenes en línea con herramientas fáciles de usar que mejoran la claridad y los detalles.
Tus imágenes generadas van a lucir más nítidas y más fieles a tus prompts que nunca!
Fuentes: https://www.reddit.com/r/StableDiffusion/comments/1f83d0t/new_vitl14_clipl_text_encoder_finetune_for_flux1/ https://www.youtube.com/watch?v=gCzJI4sKr1I&t=1s
Related Posts
Web UI vs Comfy UI: ¿Cómo deberían elegir los principiantes en pintura con IA?
Este artículo compara y contrasta dos herramientas populares utilizadas para la generación de imágenes con IA: Web UI y Comfy UI. Explora sus similitudes, antecedentes, ventajas y desventajas para ayudar a los principiantes en la pintura con IA a decidir qué herramienta podría ser más adecuada para sus necesidades.

FluxGym: GUI de entrenamiento con baja VRAM para Flux LoRA
FluxGym es una interfaz web de código abierto que permite a los usuarios entrenar Flux LoRAs en computadoras con soporte para VRAM baja (12GB/16GB/20GB), haciendo que la tecnología de fitness avanzada sea accesible para todos.